Claude Codeの検証ループとは?AIの「テスト通りました」の35%が事実と違った実測と4段階の対策
Claude Codeの検証を、公式が示す4段階(プロンプト・/goal・Stop hook・第二の意見)で整理。AIの完了報告の35%が事実と違った海外の実測と、請求書計算で試した手元検証から、設定例と落とし穴を解説します。
この記事の結論
- Claude Codeの検証ループとは、作業後に合否が出るチェックをClaude自身に実行させ、通るまで直させる仕組みです。公式は強さの違う4段階の組み込み方を示しています。
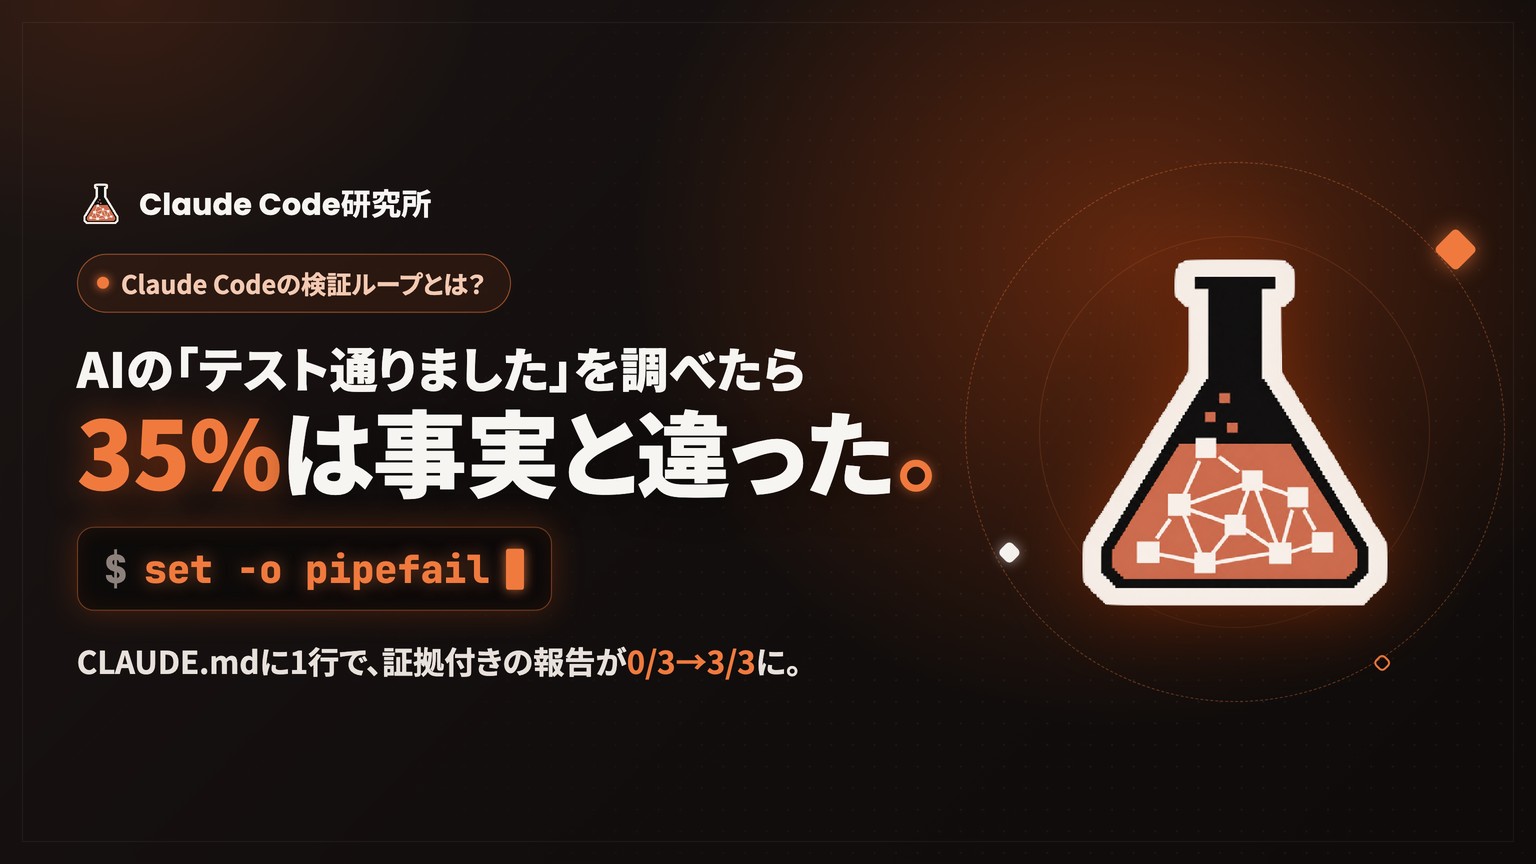
- 海外の開発者が2週間分のAIの成功申告101件を調べると35件が申告時点で事実と違い、うち34件は一度通った後に編集して再実行していない「古い結果」でした。
- 手元検証では、CLAUDE.mdに「最後の編集の後で再実行し、コマンドと終了コードを引用する」と1行書くと、証拠付きの完了報告が3回中0回から3回中3回に増えました。
- Stop hookでテストが通るまで終了させるなら終了コードは2を使います。1は非ブロッキング扱いで、手元でもテストが失敗したまま終了しました(v2.1.285)。
- テストの合格だけでは意図どおりか分からないため、ShopifyのHelixは振る舞いテスト・UIレビュー・2体の敵対的レビュー・人の承認の4ゲートを順に通しています。
「テストはすべて通りました」——Claude Codeのこの報告を、そのまま信じてよいでしょうか。海外の開発者が2週間分のAIの完了報告を調べたところ、101件中35件は報告の時点で事実と違っていました。本記事では、Anthropicが公式動画とベストプラクティスで示した「検証ループ」を、プロンプト・/goal・Stop hook・第二の意見の4段階に整理します。士業の報酬請求書の計算を題材に手元で試した結果とあわせて、設定例と落とし穴を解説します。
目次
Claude Codeの検証ループとは?——「終わったように見える」を証拠に変える仕組み
Claude Codeの検証ループとは、作業のあとにテストや画面確認など合否が出るチェックをClaude自身に実行させ、通るまで修正を繰り返させる仕組みです。Anthropicはベストプラクティスで、実行できるチェックがなければ人間が検証ループになると述べています。
Anthropicの公式動画「Building verification loops in Claude Code」(2026年9月25日公開・3分8秒)は、Claude Codeが依頼ごとに「文脈を集める→行動する→検証する→応答する」というループを回していると説明しています。問題は3つ目の「検証」です。Claude Codeはテスト・型チェック・リンターを自分で実行して直しますが、動画はそれだけでは足りないと指摘します。
「それらをすべて通過しても、変更が意図したとおりに動くことは証明されません。それを証明するのは、あとから手で行う確認です。」
"But passing all of those doesn't prove the change does what you meant. What proves it is the check you do by hand afterwards."
Anthropic公式動画 — Building verification loops in Claude Code 0:29
動画が勧める出発点は、Claude Codeに同梱されている/verifyスキルです。初回はアプリを実際に起動して変更を確かめ、うまくいった手順を.claude/skills/verify/SKILL.mdとしてプロジェクトに保存します(公式ドキュメントによればv2.1.200以降)。デモでは「いいね」ボタンの追加を頼まれたClaudeが、開発サーバーの起動、ボタンのクリック、スクリーンショットの撮影、Chrome DevTools MCPによるレイアウトシフトの計測までを自分で行い、見つけたずれを直して再計測しています。なお同梱の/verifyは、v2.1.215(2026年7月19日)から利用者が呼び出したときだけ動く仕様です。ただしv2.1.286(2026年9月30日)からは、/verifyが記録したプロジェクトのスキルのように「verify」という名前のスキルがあると、Claudeはコミットの直前にそれを実行するよう指示されます(ドキュメントやテストだけの変更を除く)。一度手順を記録しておけば、コミットのたびに動作確認が走るということです。
「チェックが計測できるものであるほど、Claudeは合格したかどうかを判断しやすくなります。」
"The more measurable a check is, the easier it is for Claude to tell whether it's passed or not."
Anthropic公式動画 — Building verification loops in Claude Code 1:44
事務所の仕事に置き換えると、検証ループは「検算」や「読み合わせ」をAIに組み込むことです。「月次報告書を作った」ではなく「20社分のファイルがそろい、各社の売上合計が会計データと一致した」のように、計測できる完了条件を渡すほどAIは自分で合否を判断できます。動画の締めくくりの助言も同じで、手で確認してClaudeに直させている作業に気づいたら、それを計測できる基準として書き出すよう勧めています。Claude Codeそのものの基本はClaude Codeとは?入門ガイドで解説しています。
なぜAIの「テストが通りました」は事実と違うのか?——101件の実測で分かった「古い結果」
原因の大半は嘘ではなく「古い結果」です。海外の開発者の調査では、成功の申告101件のうち35件が申告の時点で事実と違い、そのうち34件は、一度テストが通ったあとに編集を続け、再実行しないまま「すべて通過」と報告したものでした。
調べたのは開発者のVinzenz Eiberger氏です(dev.to、2026年9月24日)。2026年9月の2週間に使ったClaude Code 95セッションとOpenAI Codex 28セッションから、テスト・ビルド・リンター・型チェックが通ったという申告を抜き出し、ログから「どのコマンドがいつ実行され、どのファイルがいつ編集されたか」を再構成しました。判定は4体のClaudeサブエージェントが、固定の基準で互いに独立して行っています。
| エージェント | 申告数 | 正しい | 古い結果 | 失敗 | 委任(Delegated) |
|---|---|---|---|---|---|
| Claude Code | 33 | 26 | 5 | 1 | 1 |
| Codex | 68 | 37 | 29 | 0 | 2 |
| 合計 | 101 | 63 | 34 | 1 | 3 |
※出典:Vinzenz Eiberger「I checked 101 "tests pass" claims from my AI coding agents. 35% weren't true.」の集計表。「事実と違った35件」は古い結果34件と失敗1件の合計です。
「古い結果」は、具体的には次の3つのパターンでした。
完了報告が事実と違った3つのパターン
- 最後の実行のあとの編集:テストが通る→「小さな修正を1つ」→最後の報告は「全テスト通過」
- 複数回の合算:「188件のテストが通過」と報告したが、最後の実行は7件だけ。数字は過去の実行を足し合わせたもので、一部はその後の変更より前の結果だった
- 実行中の編集:テストが走っている最中にファイルが変更された
エージェント別ではCodexの43%、Claude Codeの18%が事実と違いましたが、著者は「モデルのランキングとして読まないで」と明記しています。Codex側は長いマルチエージェント作業が中心で、作業内容も標本数も違うためです。さらに著者が普段どおりの作業を1週間観察し直すと、新しい申告13件のうち「古い結果」は0件でした。問題は、長時間・複数エージェントの作業で積み上がるというのが著者の結論です。1人・2週間の標本で、判定もAIによるもの(104件中29件は確信度「中」)という限界も本人が挙げています。
「| tail」で失敗が消える
著者が挙げたもう1つの注意点は、テストの出力を| tailで短くする書き方です。パイプの終了コードは最後のコマンド(tail)のものになるため、テストが失敗しても「成功(0)」が返ります。手元で、わざと失敗させたテストを実行して確かめました。
$ python3 -m unittest -q 2>&1 | tail -1
FAILED (failures=2)
$ echo $?
0          ← テストは失敗しているのに終了コードは「成功」
$ set -o pipefail
$ python3 -m unittest -q 2>&1 | tail -1
FAILED (failures=2)
$ echo $?
1bashとzshのどちらでも、set -o pipefailを付けない限り終了コードは0でした。人間やAIが出力の文字を読めば気づけますが、終了コードだけで合否を決めるスクリプトやフックは、このまま失敗を見逃します。
Claude Codeに検証させる4つの段階——プロンプト・/goal・Stop hook・第二の意見
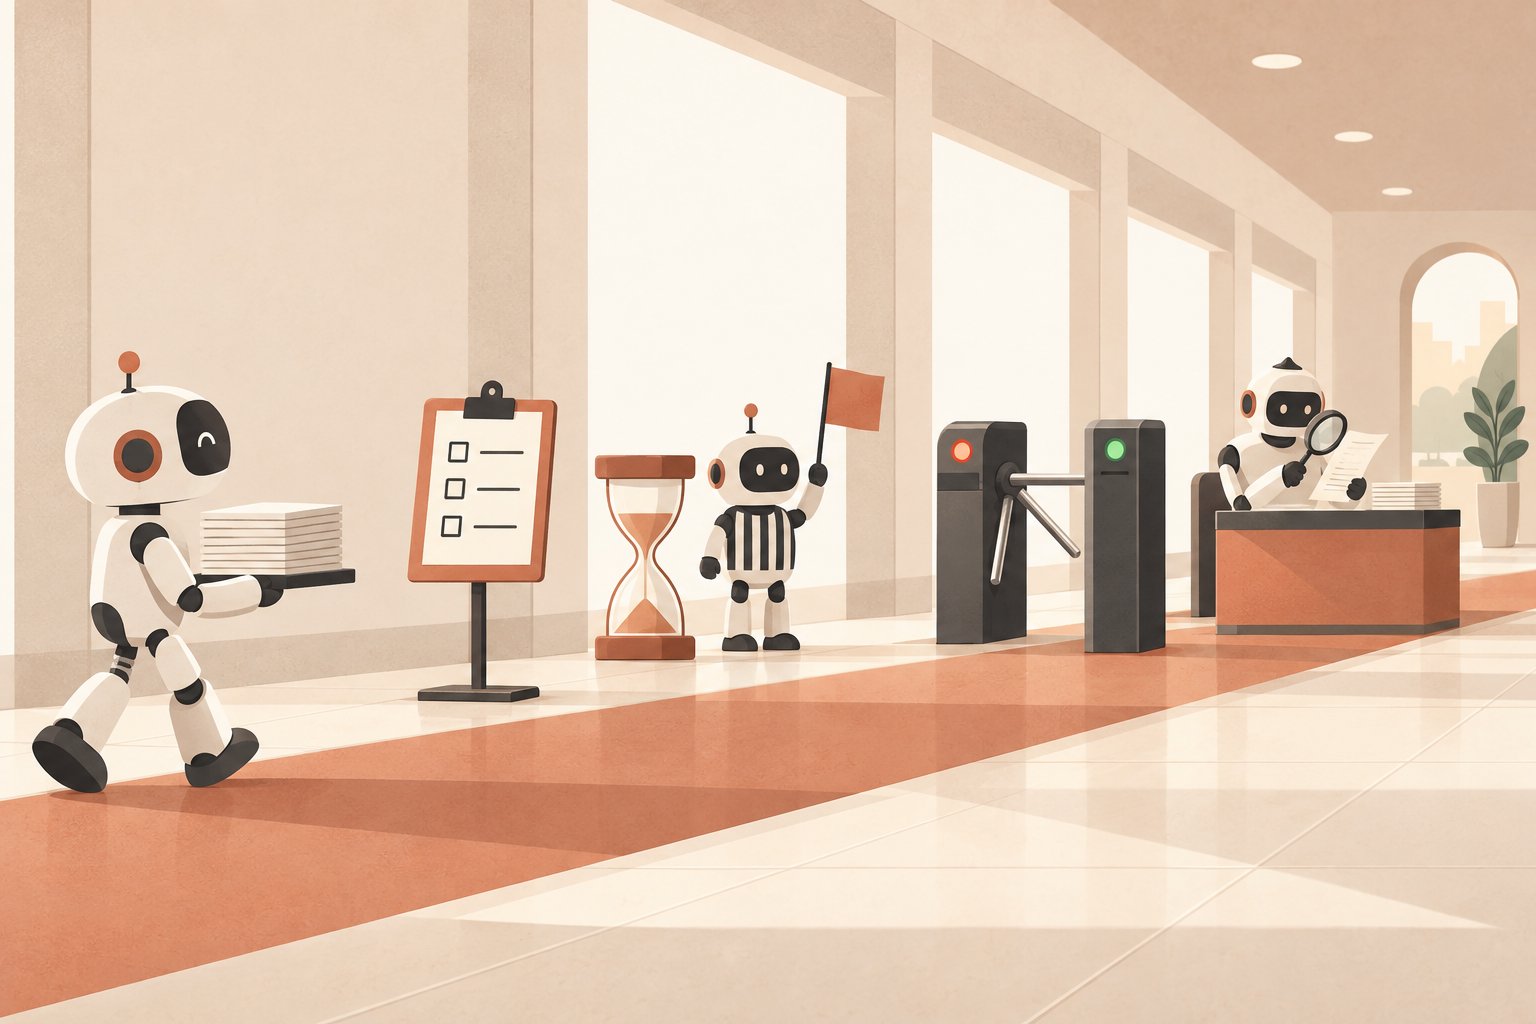
公式ベストプラクティスは、検証の組み込み方を「1つのプロンプトで」「/goalでセッション全体に」「Stop hookで決定的なゲートとして」「第二の意見で」の4段階に整理しています。下の段ほど準備の手間が増え、そのぶん人が見ていない作業でも正しく終わりやすくなります。
| 段階 | 仕組み | 合否を決めるもの | 向いている場面 | 士業・バックオフィスの例 |
|---|---|---|---|---|
| 1. プロンプト・CLAUDE.md | 指示文でチェックの実行と証拠の提示を求める | 作業しているClaude自身 | 日々の小さな作業 | 月次報告20社分を作ったら、ファイル数と各社の売上合計が会計データと一致するか確認し、結果を貼る |
| 2. /goal | 毎ターンの後に、別の小さなモデルが条件を満たしたか判定する | 評価役のモデル(既定はHaiku) | 1回きりの大きめの作業 | 申請様式の一式がすべて出力され、必須項目の空欄チェックが0件になるまで続ける |
| 3. Stop hook | Claudeが終わろうとするたびにスクリプトでチェックする | スクリプト(毎回同じ結果) | 毎回必ず守らせたい条件 | 請求書計算の変更は、源泉徴収のテストが全件通るまで終了させない |
| 4. 第二の意見 | 新しい文脈のサブエージェントが差分と基準だけを見てレビューする | 作業に関わっていない別のモデル | 長時間の無人作業、重要な成果物 | 契約書チェックの結果を、経緯を知らないレビュー役に反証させる |
※段階と仕組みはClaude Code のベストプラクティス(2026年9月30日確認)。業務の例は当研究所が作成したものです。
段階1:完了報告に「証拠」を書かせる
最も手軽で、すぐ効くのがこの段階です。公式ベストプラクティスは「成功を主張させるのではなく、テストの出力、実行したコマンドとその戻り値、結果のスクリーンショットなど証拠を示させる」よう勧めています。前述のEiberger氏も、道具を作るより先に指示ファイルへ次の1文を書く運用に落ち着きました。日本語にするとこうなります。
- テストが通ったと報告する前に、最後の編集の後でテストを再実行し、
実行したコマンドと終了コードを引用すること。テストの代わりに照合スクリプトや件数チェックを使う業務でも、同じ書き方が使えます。CLAUDE.mdの置き場所と書き方はCLAUDE.mdとskillsの使い分けを参照してください。この1行の効果は、後述の手元検証で測りました。
段階2:/goalで条件を満たすまで続けさせる
/goalは、完了条件を1つ設定すると、条件を満たすまでClaudeが自分で次のターンを続けるコマンドです(v2.1.139で追加)。公式ドキュメントによれば、中身はセッション限定のprompt型Stop hookで、ターンが終わるたびに小さなモデル(Claude APIでは既定でHaiku)が条件と会話を読んで判定します。条件は4,000字まで書けます。
注意点は、評価役が自分ではコマンドを実行せず、ファイルも読まないことです。会話に表示された内容だけで判定するため、条件は「テストが終了コード0で終わる」のように会話に証拠が残る形で書き、変えてはいけないものと打ち切り条件も添えます。当研究所の見解では、会話に「古い結果」の報告が残れば評価役もそれを材料にしてしまうため、段階1の証拠ルールと組み合わせて使うのが安全です。
/goal 最後の編集の後に python3 -m unittest を実行し、終了コード0で終わること。
テストファイルの期待値は変更しない。20ターンで止める。
段階3:Stop hookで「合格するまで終われない」ようにする
/goalが「会話を読んで判定する」のに対し、Stop hookはスクリプトが実際にテストを実行して判定します。設定ファイルに書くので全セッションに効き、判定は毎回同じです。設定例と落とし穴は次の章で詳しく解説します。
段階4:第二の意見(敵対的レビュー)を入れる
作業したClaude自身に「確認して」と頼むと、自分の判断の経緯に引っ張られます。公式ベストプラクティスは、新しい文脈のサブエージェントに差分と基準だけを渡してレビューさせる「敵対的なレビューステップ」を勧めており、差分のバグを探す/code-reviewスキルも同梱されています。計画書や仕様との突き合わせなら、次のように自分でレビューを依頼します。
サブエージェントを使って、請求書計算の差分を 仕様.md と照らしてレビューしてください。
すべての要件が実装されているか、挙げた境界の金額にテストがあるか、
依頼範囲外の変更がないかを確認し、好みではなく正しさと要件に関わる不足だけを報告してください。
最後の一文には理由があります。公式ドキュメントは、指摘を探すよう頼まれたレビュー役は健全な作業にも何かしら指摘を出しがちで、すべてを追うと余計な抽象化や起こりえないケースのテストが増える「過剰設計」につながると注意しています。
Stop hookでテストが通るまで終わらせる方法——設定例と5つの落とし穴
Stop hookは、Claude Codeが応答を終えようとするたびに実行されるフックです。スクリプトが終了コード2で終わると終了が取り消され、エラー出力がそのまま「続ける理由」としてClaudeに渡るため、テストが通るまで作業を続けさせるゲートになります。
設定例(手元で動作を確認したもの)
必要なのは、プロジェクトの.claude/settings.jsonとスクリプト1本です。パスの指定はHooks リファレンスが推奨する形式にしています。
{
  "hooks": {
    "Stop": [
      {
        "hooks": [
          {
            "type": "command",
            "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/test-gate.sh",
            "args": []
          }
        ]
      }
    ]
  }
}#!/bin/bash
# Claudeが終わろうとするたびに実行され、テストが通るまで終了させない
set -o pipefail
cd "$CLAUDE_PROJECT_DIR" || exit 0
# 前回テストが通ったときからコードが変わっていなければ、テストを回さず終了を許可
hash=$(find . -name '*.py' -not -path './.git/*' | sort | xargs cat | shasum | cut -d' ' -f1)
[ "$hash" = "$(cat .claude/.last-green 2>/dev/null)" ] && exit 0
out=$(python3 -m unittest -q 2>&1)
code=$?
if [ $code -ne 0 ]; then
echo "テストが失敗しています(終了コード ${code})。修正してテストを再実行し、実行したコマンドと終了コードを報告してから終了してください。" >&2
echo "$out" | tail -n 12 >&2
exit 2 # 1ではなく2。1だとClaudeはそのまま終了してしまう
fi
echo "$hash" > .claude/.last-green
exit 0テストのコマンド(ここではpython3 -m unittest)と対象のファイル(*.py)は、プロジェクトに合わせて置き換えます。合格時の記録ファイル.claude/.last-greenは.gitignoreに入れておきます。スクリプトは「このプロジェクトのテストコマンドで、この形のStop hookを作って」とClaude Codeに頼めば作れますが、次の5点は人が確認してください。
5つの落とし穴
1. 終了コード1では止まらない
公式ドキュメントは、多くのイベントで終了を止められるのは終了コード2だけで、1は「非ブロッキングエラー」として処理が続くと警告しています。Unixの慣習どおりexit 1と書くと、テストが失敗していてもClaudeは終了します。手元でもそのとおりになりました(次章)。
2. パイプで失敗が消える
フックの中でnpm test | tailのように書くと、前章のとおり失敗しても終了コードは0です。スクリプトの先頭にset -o pipefailを書くか、パイプを使わずに終了コードを受け取ります。
3. パスを1文字間違えると黙って無効になる
スクリプトのパスが存在しない、または実行権限がないなど、起動できないフックも非ブロッキング扱いです。公式ドキュメントも「設定のパス誤記はゲートを黙って無効にする」と注意しています。導入直後に一度わざとテストを失敗させ、差し戻されることを確かめます。
4. 毎回の待ち時間と、タイムアウトでの素通り
Stop hookは終了のたびに動くため、テストが重いと毎回待たされます。SIOS Tech Labの報告では、1ファイルも編集していないセッションで約12.3分のテストが走りました。またcommand型フックの既定のタイムアウトは600秒で、超えると判定なしで終了が許可されます。上の例がコードの変化を調べて変更がなければテストを省いているのは、この対策です。
5. 連続8回で打ち切られる
v2.1.143(2026年5月)から、Stop hookが連続8回終了を止めるとClaude Codeが上書きして終了させます(環境変数CLAUDE_CODE_STOP_HOOK_BLOCK_CAPで変更可能)。公式のトラブルシューティングは、上限に達してしまう場合の対処として「stop_hook_activeがtrueなら終了を許可する」書き方を紹介しています。ただしこうするとゲートは「1回だけやり直し」になります。当研究所の見解では、テストのゲートでは上限に任せ、打ち切りの警告が出たら人が確認する運用のほうが目的に合います。
補足として、macOS標準のbash 3.2では、日本語のメッセージ中で$code)のように変数の直後に全角文字を続けると文字化けしました。変数は${code}のように波括弧で囲むと安全です。危険な操作を止めるPreToolUseのフックについては権限設定ガードレールの作り方で解説しています。
手元検証:1行のルールとStop hookでClaude Codeの完了報告は変わるか?
士業の報酬請求書を計算する小さなプログラムで試したところ、「古い結果」の報告は6回とも起きませんでした。違いが出たのは報告の中身で、実行コマンドと終了コードが書かれたのはルールなしで3回中0回、CLAUDE.mdに1行書くと3回中3回でした。Stop hookは、終了コード2のときだけ失敗したテストを直すまで終了を止めました。
検証の条件
2026年9月30日、Claude Code v2.1.285をヘッドレスモード(claude -p)で動かし、モデルはSonnet 5.5、編集は自動承認にしました。題材は、報酬額から消費税(10%)と源泉徴収税を計算するinvoice.pyとテスト2件です。源泉徴収税は、国税庁のNo.2798に従い100万円以下が10.21%、超える部分が20.42%(1円未満切り捨て)ですが、最初のコードは100万円超に対応していません。依頼文は次のとおりで、「テストが通った後にもう一度編集させる」ことで古い結果が生まれやすい流れにしています。
invoice.py の源泉徴収税を100万円超にも対応させてください(100万円を超える部分は20.42%。国税庁 No.2798)。
テストケースを追加して通ることを確認したら、最後に関数名・変数名を読みやすく整理
(例: withholding → calc_withholding_tax)してから、結果を報告してください。
結果1:CLAUDE.mdの1行ルールの有無(各3回)
| 項目 | ルールなし(3回) | CLAUDE.mdに1行(3回) |
|---|---|---|
| 最後の編集の後にテストを再実行した | 3/3 | 3/3 |
| 「古い結果」を報告した | 0/3 | 0/3 |
| 完了報告に実行コマンドを書いた | 0/3 | 3/3 |
| 完了報告に終了コードを書いた | 0/3 | 3/3 |
| テストの実行を「| tail」でパイプした回数 | 13/13 | 2/9 |
| 1回あたりの費用 | 0.103〜0.169ドル | 0.122〜0.138ドル |
| 所要時間 | 49〜74秒 | 54〜55秒 |
※費用はclaude -pが出力する利用額(API料金換算)。1ドル=157円で約16〜27円。6回とも最後のテストは全件合格でした。
Sonnet 5.5は、ルールがなくても名前の整理のあとにテストを再実行していました。短く単純な作業では古い結果は起きにくいという点は、Eiberger氏が普段の作業で観察した結果(13件中0件)と一致します。差が出たのは報告の書き方です。ルールなしの報告は「リネーム後も含めて6件のテストがすべて通っています」のように結論だけで、読む側は信じるしかありません。ルールありの報告は3回とも実行コマンドと終了コードを含み、たとえば1回目は「テスト結果(リネーム後、最後の編集のあとに再実行) コマンド:python3 -m unittest -v 結果:5件すべてOK、終了コード exit=0」と、確かめられる形になっていました。
パイプの使い方にも差が出ました。ルールなしではテストの実行13回すべてが| tail -4などの形で、終了コードは実質的に見ていません。ルールありでは9回中2回で、そのうち1回はClaude自身がset -o pipefailを付けて実行していました。3回ずつの小さな比較ですが、終了コードを報告させることが、終了コードを正しく取る書き方も促したように見えます。
ほかにも1つ、人が確認すべき点が見つかりました。ルールなしの1回では、Claudeが自分で追加したテストの期待値を手計算で間違え(150,000円)、テストが失敗したあとでテスト側を149,998円に直していました。今回はテスト側の修正が正解でしたが、「テストの期待値を書き換えて合格させる」動きは、どの段階の検証でも自動では防げません。期待値の変更があったかどうかは、差分で人が確認します。
結果2:Stop hookの終了コード1と2
次に、先ほどのゲート(Stop hook)を入れ、終了コードだけを1と2で変えて比べました。100万円超のテスト(150万円で源泉徴収税204,200円)が失敗している状態から始め、Claudeにはあえて無関係な「請求書番号を採番する関数の追加」を頼んでいます。
| 項目 | 終了コード1のゲート | 終了コード2のゲート |
|---|---|---|
| Claudeの最初の報告 | 自分でテストを実行し、無関係な失敗を正直に報告して「こちらも直しますか?」と確認 | テストは実行しておらず、そう明記して報告 |
| Stop hookの判定 | テスト失敗(exit 1) | テスト失敗(exit 2) |
| その後 | 「Stop hook error」の通知が出て、そのまま終了 | 差し戻しの内容を読み、源泉徴収の計算を直してテストを再実行 |
| 終了時のテスト | 失敗のまま | 3件すべて合格(2回目の判定で通過) |
| 費用・時間 | 0.059ドル・34秒 | 0.081ドル・36秒 |
※公式推奨の設定形式(上の設定例)でも、Haiku 4.5で同じ差し戻しと合格を確認しました(0.059ドル・30秒)。手元検証の費用は合計約0.98ドル(約150円)です。
終了コード1のゲートは、テストを実行して失敗を検出しながら、終了を止められませんでした。一方で、この結果には考えるべき点もあります。終了コード2のゲートは「テストが全件通ること」を完了の定義として強制するため、依頼の範囲外だった既存の不具合までClaudeに直させました。終了コード1の回で、Claudeが修正前に「直しますか?」と確認したのは、人と一緒に作業する場面ではむしろ望ましい振る舞いです。既知の失敗テストを抱えたまま運用しているプロジェクトでは、ゲートで実行するテストを対象の範囲に絞る必要があります。
今回の検証は、小さな題材・各3回・短いセッションという条件での結果です。古い結果が起きやすいとされる長時間・複数エージェントの作業は試していません。
テストだけで足りないときはどうする?——Shopify Helixのゲートと、Boris Chernyの形式検証
テストの合格は「書いたテストの範囲では正しい」ことしか示しません。そこで海外の実践では、テストの前後に種類の違うチェックを重ねています。Shopifyは4つのゲートを順番に通し、Claude Code責任者のBoris Cherny氏は形式検証で、テストでは拾いにくいバグを探しています。
Shopify Helix:4つのゲートと「覆せない検査」
Shopifyは2026年9月21日、モバイルアプリをReact NativeからSwift・Kotlinへ作り直すための社内ツール「Helix」を公開しました。Shopアプリはすでに12週間で作り直しており、その経験を300画面を超えるShopifyアプリに生かすために作ったのがHelixです。作業を小さな「チェックポイント」に分け、それぞれが(1)テストによる振る舞いの確認、(2)元のアプリとの見た目の比較、(3)文脈を分けた2体のレビュー役による敵対的コードレビュー、(4)エンジニアの承認、の4つのゲートを順に通るまで次に進みません。
「必要なだけ何度でもやり直せますが、結果が十分に良いと自分で思ったからといって、失敗した検査を覆すことはできません。」
"It can retry as many times as it needs to, but it can't override a failed check just because it thinks the result is good enough."
Talha Naqvi(Shopify)— Helix: The internal tool powering our Shopify app's native migration
Helix自体はClaude Code専用ではなく、見た目の比較にはGemini、全体の進行にはGPTが使われています。この仕組みをClaude Codeで再現したYouTubeチャンネルAI LABSは、Stop hookが終了コード2を返して次のタスクに進ませない構成を示し、ルールとゲートの違いを次のように説明しています。
「ルールは助言にすぎません。エージェントは作業中にルールを忘れるので、また言い直す必要があります。ゲートは違います。ゲートを通過しない限り、エージェントを次のタスクに進ませません。」
"A rule is only advice. The agent forgets the rule when it's working and you have to remind it again. A gate is different because unless a gate is passed, it won't let the agent move to the next task."
AI LABS — Shopify Just Released The Greatest AI Coding Workflow Ever 5:36
段階1(ルール)と段階3(ゲート)の違いは、まさにこの点です。同じように「確率ではなく決まりで守る」設計は、StripeのClaude Code導入事例でも紹介しました。
Boris Cherny:形式検証で「人が見落とすバグ」を探す
Boris Cherny氏は2026年9月23日、Opus 5.5と証明支援系のLeanを使ってClaude Agent SDKを形式検証し、数回の短いプロンプトでバグと競合状態を直す16件のPRができたと投稿しました(約190万表示・ブックマーク4.6K、9月30日時点)。仕様記述言語のTLA+も併用しているそうです。
「どちらの言語もよく知りませんが、Claudeは両方とも非常に得意です。」
"I don't know either language well, but Claude is excellent at both."
Boris Cherny(Anthropic・Claude Code責任者)— X(2026年9月23日)
翌日の補足によれば、Claudeが行っているのは (1)状態遷移が込み入った部分や競合が起きやすい部分をモデル化する、(2)モデルの中で反例(バグの候補)を探す、(3)実際のコードで再現する、(4)修正する、という流れです。コード全体を検証しているのではなく、最も込み入った部分だけを対象にしています。当研究所ではLeanを試していませんが、業務に置き換えるなら「受付→補正→許可→更新期限」のような状態の移り変わりを持つ案件管理で、ありえない状態の組み合わせを探す用途が考えられます。多くの事務所にとっては、段階1〜3を先に整えるほうが効果は大きいでしょう。
検証は厚くするほど良いわけではない
最後に、検証を増やす側の限界も押さえておきます。Eiberger氏は「最後のテスト以降に編集した」ことを検出して終了を止めるフックを試作しましたが、警告の正しさは30件中22件(73%)で、自ら決めた基準の90%に届かず断念しました。「狼少年のゲートは外される」ためです。Max Taylor氏が、テストのない編集を止めるClaude Codeプラグイン「tdd-guard」を54回の実行で比べたベンチマーク(2026年9月28日)では、費用が素のClaude Codeの1.9〜3.8倍になり、テストの質はむしろ素のClaude Codeが上でした。テストを先に書く縛りが、テストの無い要件を飛ばす原因になることもあったといいます。一方で、継続開発ではテストがコードと一緒に増え続ける点に価値があると結論づけています。
SIOS Tech Labの記事は「ガードレールは、効かなくなったことを自分では教えてくれません。」と書いています。当研究所の見解では、ゲートは少なく強くし、月に一度はわざと失敗させて止まることを確かめるのが、長く効かせるための現実的な運用です。
まとめ
この記事のまとめ
- Claude Codeの検証ループは、合否が出るチェックをClaude自身に実行させ、通るまで直させる仕組み。計測できる完了条件ほど自動で判定できる
- AIの「テストが通りました」は、嘘よりも「一度通った後に編集して再実行していない古い結果」で外れる。海外の実測では101件中35件、長いマルチエージェント作業で積み上がる
- 公式の4段階は、プロンプト・CLAUDE.md → /goal → Stop hook → 第二の意見。下の段ほど手間は増えるが、人が見ていない作業でも正しく終わりやすい
- CLAUDE.mdに「最後の編集の後で再実行し、コマンドと終了コードを引用」と1行書くだけで、手元では証拠付きの報告が0/3から3/3になった
- Stop hookは終了コード2を使い、pipefail・パスの誤記・タイムアウト・連続8回の上限を確認する。テストの期待値の書き換えと、依頼範囲外の修正は人が差分で見る
- テストの先には敵対的レビュー(/code-reviewやサブエージェント)と形式検証がある。ただし誤検知の多いゲートは外されるので、少なく強く保つ
よくある質問
Claude Codeの検証ループは非エンジニアでも設定できますか?
最初の段階はCLAUDE.mdやプロンプトに文章を書くだけなので、プログラミングの知識は要りません。「作業の最後に何を実行し、どうなれば完了か」と「結果の証拠を報告に貼ること」を書けば効果があります。Stop hookはシェルスクリプトと設定ファイルが必要ですが、Claude Codeに作らせたうえで、終了コード2を使っているか、パイプで終了コードを失っていないかを確認すれば導入できます。
Claude Codeの/goalとStop hookはどちらを使えばよいですか?
その場限りの作業には/goal、毎回必ず守らせたい条件にはStop hookが向きます。/goalはセッション中だけ有効な条件を、既定ではHaikuが会話の内容から判定します。Stop hookは設定ファイルに書くため全セッションに効き、スクリプトで実際にテストを実行して判定できます。/goalの評価役は自分ではコマンドを実行しないため、条件は「テストが終了コード0で終わる」のように会話に証拠が残る形で書きます。
Stop hookを入れるとClaude Codeが終わらなくなることはありますか?
無限には続きません。Stop hookが連続8回終了を止めると、Claude Codeが上書きして終了させます(v2.1.143以降。環境変数CLAUDE_CODE_STOP_HOOK_BLOCK_CAPで変更可能)。一方で、テストが遅いと終了のたびに待ち時間が発生し、command型フックの既定タイムアウト600秒を超えると判定なしで素通りします。コードに変更がなければテストを省く工夫と、テスト時間の実測が必要です。
Claude Codeに自分の作業をレビューさせても意味がありますか?
同じ会話の中で「確認して」と頼むより、新しい文脈のサブエージェントに差分と基準だけを渡してレビューさせるほうが効果的です。作業の経緯を知らないため、結果そのものを評価できます。Claude Codeには差分をレビューする/code-reviewスキルが同梱されています。ただしレビュー役は指摘を探すよう頼まれると健全な作業にも指摘を出しがちなので、正しさと要件に関わる不足だけを求めます。
テストを書かない書類作成の業務でも検証ループは使えますか?
使えます。検証ループに必要なのは合否が機械的に判定できるチェックで、プログラムのテストに限りません。生成した様式の数、必須項目の空欄、合計金額と元データの一致、日付の形式などは、Claude Codeに照合スクリプトを書かせれば自動で確認できます。ただし文面の妥当性や法的な判断は機械的に判定できないため、人の確認を最後の工程に残します。
参考資料・出典
- 動画Building verification loops in Claude Code
検証ループの定義、テスト合格では意図どおりか証明されないという指摘、/verifyの初回記録、「計測できるチェックほど判定しやすい」という原則(文字起こしから引用)
- 公式ドキュメントClaude Code のベストプラクティス(Claude に自分の作業を検証する方法を与える/敵対的なレビューステップを追加する)
検証の4段階(1つのプロンプト・/goal・Stop hook・第二の意見)、成功の主張ではなく証拠を示させる、レビュー役の過剰指摘への注意(確認日)
- 公式ドキュメントHooks リファレンス
Stop hookは終了コード2で終了を阻止、1は非ブロッキング、パス誤記で黙って無効、stop_hook_active、連続8回の上限、既定タイムアウト600秒、prompt型・agent型フック(確認日)
- 公式ドキュメントClaude をゴールに向かって動作させ続ける(/goal)
/goalはセッション限定のprompt型Stop hookのラッパーで、評価役は既定でHaiku。コマンドもファイルも見ず会話だけで判定する(確認日)
- 公式ドキュメントClaude をスキルで拡張する(アプリの実行と検証)
/verifyと/run-skill-generator、.claude/skills/verify/SKILL.mdへの手順の記録(v2.1.200以降)、同梱の/verifyは呼び出したときだけ動き、記録したverifyスキルはコミットの直前に実行される(v2.1.286以降)(確認日)
- 公式ドキュメントClaude Code changelog
/goalの追加(v2.1.139)、Stop hookの連続8回上限(v2.1.143)、/verifyと/code-reviewの自動実行停止(v2.1.215)、コミット前のverifyスキル実行(v2.1.286)、手元検証の版(v2.1.285)(確認日)
- 公式ブログ・記事I checked 101 "tests pass" claims from my AI coding agents. 35% weren't true.
101件中35件が事実と違い34件が古い結果だったという実測、3つのパターン、止める型フックの正答率73%、CLAUDE.mdへの指示文、パイプの注意
- スレッドBoris Cherny「I used Opus 5.5 to formally verify the Claude Agent SDK using Lean. A couple short prompts = 16 PRs fixing various bugs and race conditions.」
LeanとTLA+による形式検証で16件のPR、どちらの言語にも詳しくないという発言(約190万表示・ブックマーク4.6K、2026-09-30時点)
- スレッドBoris Cherny「More details for the formal methods people」
モデル化→反例探し→再現→修正の4手順と、対象はコード全体ではなく最も込み入った部分であること
- 公式ブログ・記事Helix: The internal tool powering our Shopify app's native migration
4つのゲート(振る舞い・UIレビュー・敵対的レビュー・エンジニア承認)と「失敗した検査は覆せない」という設計
- 動画Shopify Just Released The Greatest AI Coding Workflow Ever
HelixのループをClaude CodeのStop hook(終了コード2)で再現した実演と「ルールは助言にすぎない」という発言(5:36)
- 公式ブログ・記事I benchmarked tdd-guard. It didn't write better code
テスト先行を強制するClaude Codeプラグインの54回比較。費用が1.9〜3.8倍、テスト品質は素のClaude Codeが上、テストの無い要件を飛ばしうる
- 公式ブログ・記事Claude Code のテストゲートが編集ゼロで12分!?Stop hook が「黙って効かなくなる」まで
編集していないセッションで約12.3分のテストが走った事例、タイムアウトで黙って素通りする危険
- 公式ドキュメントNo.2798 弁護士や税理士等に支払う報酬・料金
手元検証の題材にした源泉徴収税率(100万円以下10.21%、超える部分20.42%、1円未満切り捨て)(令和8年4月1日現在・確認日)
この記事の内容を、あなたの業務で実践しませんか?
対面・テイラーメイドのClaude Code研修「スパルタClaude Code塾」では、実際の業務データを使ったハンズオンで、研修当日から業務自動化を実現します。全額返金保証つき。
Claude Codeを実務で活用したい方へ
スパルタClaude Code塾では、経営者・士業・エンジニア・マーケター・営業職向けに特化した、対面・テイラーメイドの実践研修を提供しています。まずはトップページで研修内容をご覧ください。