Claude Fable 5.2は何がすごい?Opus 5.5・Fable 5.1とClaude Codeで実測比較
Claude Fable 5.2を公式ベンチマークとClaude Codeの実測で検証。Fable 5.1より出力は約3割速く、費用は2〜4割安く、ヒートマップの誤差は約11分の1に。業務課題の正確さはOpus 5.5と並びました。
この記事の結論
- Claude Fable 5.2は公式の表で、FrontierCode 2.0が49.1%(Fable 5.1は32.4%)、Remote Labor Indexが41.3%(同17.9%)と大きく伸びました。
- Claude Code v2.1.321の実測では、Fable 5.2(medium)はFable 5.1(medium)より出力が約34%速く、1回の費用が18〜43%安くなりました。
- 色だけで値を表すヒートマップの読み取りでは、平均誤差がFable 5.1の16〜18%に対し、Fable 5.2は約1.5%でした。
- 当研究所の業務課題(支払予定表・勤怠計算・グラフ読み取り)ではOpus 5.5(medium)もほぼ同じ正確さで、1回の費用はFable 5.2(medium)の43〜54%でした。
- Claude CodeでのFable 5.2の既定effortはmedium(APIはhigh)です。Max・Ultraは週の上限の50%まで、Proは使用量クレジット払い(11月16日までは50%まで含む)で使えます。
Anthropicが2026年11月9日に出したClaude Fable 5.2は、Fable 5.1の後継にあたる最上位モデルです。公式のベンチマークでは、長く難しい仕事の成績が大きく伸びました。では、Claude Codeで普段の仕事に使うと何が変わるのか。当研究所は同じ課題をOpus 5.5・Fable 5.1・Fable 5.2で計82回解かせ、正確さ・時間・費用を比べました。結論から言うと、Fable 5.1と比べて出力が約34%速くなり、費用は18〜43%下がりました。ヒートマップの読み取り誤差は約11分の1に縮まり、Fable 5.1で起きた安全策の誤った停止も起きませんでした。一方で、1時間以内に終わる業務課題では、既定のOpus 5.5も同じ正確さでした。
目次
Claude Fable 5.2とは?何が変わったのか
Claude Fable 5.2は、Anthropicが一般向けに提供する最上位のモデルで、2026年11月9日に公開されました。前の版のFable 5.1と比べて、コーディング・推論・画像の読み取りが強くなり、出力は最大30%速く、API単価は2割安くなりました。Claude Codeでは v2.1.321 以降で使えます。
同じ日に、同じ基盤モデルを使うClaude Mythos 5.2も公開されました。Mythos 5.2はサイバーセキュリティと生命科学の審査プログラムに参加した組織だけが使えます。一般向けのFable 5.2は、悪用のおそれがある分野で安全策(分類器による停止)がかかった版です。主な変更点は次のとおりです(Anthropicの発表、モデル一覧)。
| 項目 | Fable 5.1 | Fable 5.2 |
|---|---|---|
| API単価(100万トークンあたり) | 入力10ドル・出力50ドル | 入力8ドル・出力40ドル |
| キャッシュ読み込み | 0.25ドル | 0.20ドル |
| 出力の速さ | — | 最大30%速い(公式) |
| 安全策による不要な停止 | — | 約55%減(サイバー約60%減・生物約40%減) |
| 文脈の長さ・最大出力 | 100万トークン | 100万トークン・最大12.8万トークン |
| Claude Codeでの既定effort | high | medium(APIの既定はhigh) |
| 必要なClaude Codeの版 | v2.1.257以降 | v2.1.321以降 |
※2026年11月10日時点。出典:Anthropicの発表、Claude Platformのモデル一覧、Claude CodeのModel configurationとChangelog。速さと停止の減少はAnthropicの測定値です。
反響も大きく、Hacker Newsの発表スレッドは866ポイントを集めました(HN)。Claude Codeそのものの基本はClaude Codeとは(入門ガイド)にまとめています。
公式ベンチマークで何がすごいのか?Fable 5.1・Opus 5.5との差
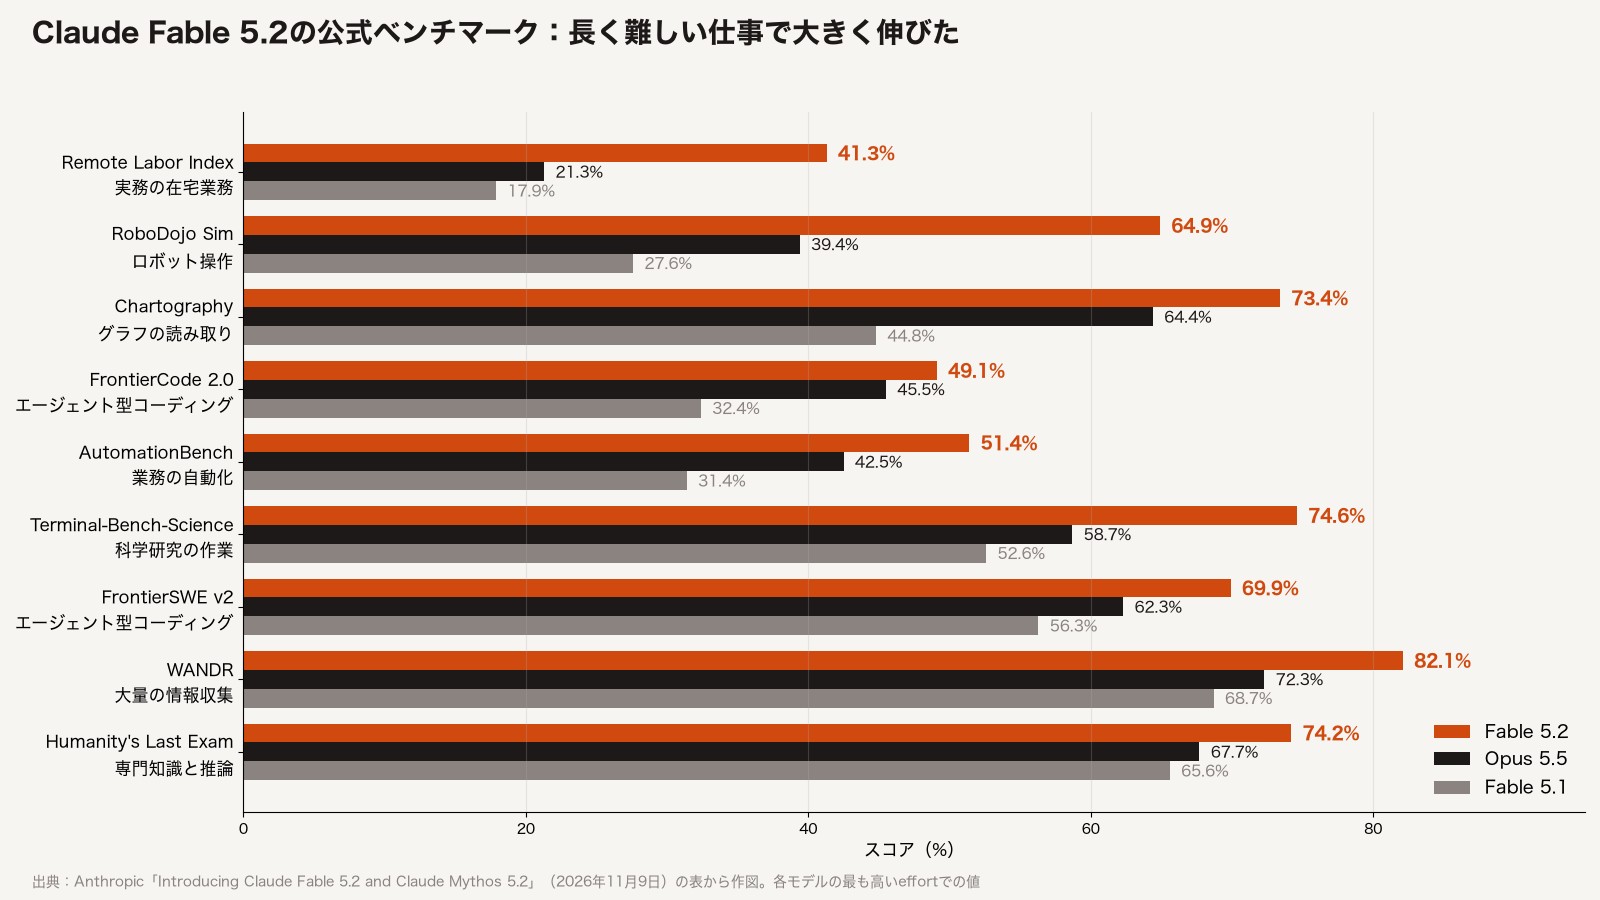
Fable 5.2が大きく伸びたのは、長い時間をかけて自分で進める仕事です。公式の表では、実際の在宅業務の依頼をこなすRemote Labor Indexが17.9%から41.3%へ2倍以上になり、オープンソースのメンテナーに採用される変更を書けるかを測るFrontierCode 2.0も32.4%から49.1%に上がりました。Fable 5.1は多くの項目でOpus 5.5に負けていましたが、Fable 5.2はほぼ全項目でOpus 5.5を上回りました。
| 分野・ベンチマーク | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| 実務の在宅業務(Remote Labor Index) | 41.3% | 17.9% | 21.3% |
| ロボット操作(RoboDojo Sim) | 64.9% | 27.6% | 39.4% |
| グラフの読み取り(Chartography・道具なし) | 73.4% | 44.8% | 64.4% |
| エージェント型コーディング(FrontierCode 2.0) | 49.1% | 32.4% | 45.5% |
| 業務の自動化(AutomationBench) | 51.4% | 31.4% | 42.5% |
| 科学研究の作業(Terminal-Bench-Science 0.1) | 74.6% | 52.6% | 58.7% |
| エージェント型コーディング(FrontierSWE v2) | 69.9% | 56.3% | 62.3% |
| 大量の情報収集(WANDR) | 82.1% | 68.7% | 72.3% |
| 専門知識と推論(Humanity's Last Exam・道具あり) | 74.2% | 65.6% | 67.7% |
| 知的作業(AA-Briefcase v1.1) | 66.1%(Elo 1785) | 61.5%(Elo 1669) | 61.2%(Elo 1800) |
| パソコン操作(OSWorld 2.1) | 89.3% | 83.5% | 87.2% |
※出典:Anthropicの発表の表。特記のない限り、各モデルの最も高いeffortでの値で、Fable 5.2のFrontierCodeはxhigh、Remote Labor Indexはhighです。他社モデル(GPT-6 Astra、Gemini 4 Carbon)の列は省きました。AutomationBenchはGemini 4 Carbonの53.9%が最高です。
もう一つの特徴は、少ない費用でOpus 5.5の最高値に届くことです。発表に載った「正答率と1タスクあたりの費用」の図では、次の結果が示されています。
- FrontierCode 2.0:effortをhighにしたFable 5.2は45.3%で、maxにしたOpus 5.5の45.5%とほぼ同じ。1タスクあたりの費用は約半分
- WANDR:mediumのFable 5.2がOpus 5.5の最高値に並び、費用は約40%
- Humanity's Last Exam:lowのFable 5.2がOpus 5.5の最高値に並び、費用は10分の1未満
- Chartography:mediumのFable 5.2が66.4%で、maxのOpus 5.5(64.4%)を上回り、費用は10分の1未満
規模の大きな例として、Anthropicは1,000体のFable 5.2のエージェントに、フェルマーの最終定理の証明を数学の証明支援系Leanで形式化させました。研究者の手助けなしに28.7時間で完了し、出力トークンは9月の前回の3分の1、証明の長さは7分の1だったと報告しています(claude.devの記事)。同じ仕組みのOpus 5.5は、18時間で26%しか進みませんでした。
ただし、これらはすべてAnthropicの測定です。他社の独立した検証はまだ出ていません。また、知的作業のAA-BriefcaseではElo(相対評価)でOpus 5.5の1800がFable 5.2の1785をわずかに上回っています。どの項目でも勝つわけではない点は押さえておきましょう。
Claude Codeで実測するとFable 5.2は何が変わった?
当研究所の実測では、Fable 5.2はFable 5.1より出力が約34%速くなり、1回の費用が18〜43%下がりました。ヒートマップの読み取り誤差は約11分の1になり、Fable 5.1で起きた安全策の誤った停止も起きませんでした。一方、既定のOpus 5.5も課題の正確さはほぼ同じで、費用はFable 5.2の約半分でした。
検証の方法
2026年11月10日、Claude Code v2.1.321をヘッドレスモード(claude -p)で動かし、架空の業務データで6種類の課題を解かせました。条件は4つで、effortは毎回明示しました。採点の正解は作業フォルダの外に置きました。実行後に各回の記録(サブエージェントを含む)を調べ、正解ファイルを読んだ形跡がないことも確認しています。
検証した課題(すべて架空のデータ)
- 支払予定表(易):取引先・発注・納品・請求のCSVから、支払規程10条どおりに15件の支払日・源泉徴収・振込手数料などを計算する
- 支払予定表(難):36件に増やし、規程に書いていない異常を6件混ぜる(振込先口座がマスタと違う2件、インボイス登録番号の不一致、他社の発注番号、存在しない発注番号、未登録の取引先)。正解はすべて「保留」
- 勤怠計算:架空の就業規則(法定休日をまたぐ勤務、週40時間、月60時間超、深夜)どおりに割増賃金の計算関数を書く。隠しテスト25件で採点
- グラフ読み取り(易):数値ラベルのない棒グラフなど3枚から60個の値を読む
- グラフ読み取り(難):色だけで値を表すヒートマップ(96マス)、対数目盛りの折れ線、社名つきの散布図から186個の値を読む。プログラムで画素を調べられないよう、Bashは使えない設定
- Markdown変換器(長時間):外部ライブラリなしで、CommonMark 0.31.2準拠の変換器を一から書く。公式仕様の652例で採点(例は渡さない)
条件:Opus 5.5(medium・Claude Codeの既定)/Fable 5.1(medium)/Fable 5.2(medium・Claude Codeの既定)/Fable 5.2(high)。各課題3〜5回(Markdown変換器は各1回)。
結果1:ヒートマップ以外の正確さはほぼ横並び
ヒートマップ以外の課題では、どのモデルもほぼ満点でした。大きな差が出たのはヒートマップの読み取りで、Fable 5.1だけ誤差が16.7%と大きく外れました。ほかに、規程に書いていない異常を保留にするかどうかで、わずかに判断が分かれました。
| 課題 | Opus 5.5(medium) | Fable 5.1(medium) | Fable 5.2(medium) | Fable 5.2(high) |
|---|---|---|---|---|
| 支払予定表(易)15件 | 全問正解 3/3回 | 全問正解 3/3回 | 全問正解 3/3回 | 全問正解 3/3回 |
| 支払予定表(難)異常6件の保留 | 6件 4/5回、5件 1/5回 | 6件 5/5回 | 6件 5/5回 | 6件 2/2回 |
| 勤怠計算 隠しテスト25件 | 25/25 3/3回 | 25/25 3/3回 | 25/25 3/3回 | 25/25 3/3回 |
| グラフ読み取り(易)60値 | 誤差0.05% | 誤差0.07% | 誤差0.04% | 誤差0.04〜1.67% |
| ヒートマップ96マスの平均誤差 | 1.96% | 16.7% | 1.46% | 1.14% |
| Markdown変換器 公式652例 | 652/652 | 652/652 | 652/652 | 652/652 |
※誤差は、目盛りの幅(ヒートマップは0〜120人)に対する読み取り誤差の平均。Fable 5.1のヒートマップは、安全策に止められなかった3回の平均です(結果4を参照)。支払予定表(難)の値引きだけのマイナス請求1件は、支払と保留のどちらも妥当なため、試行後に採点から外しました。Fable 5.2(high)のグラフ(易)で誤差が1.67%になった1回は、60値のうち1つを書き忘れた回です。2026年11月10日、Claude Code v2.1.321。
Opus 5.5で判断が分かれた1件は、請求書のインボイス登録番号が取引先マスタと違うケースでした。マスタでは「登録なし」の取引先の請求書に、登録番号が書かれています。Opus 5.5は5回中1回、備考に不一致を書いたうえで「支払」にしました。Fableは2つの版とも12回すべてで保留にし、備考に「登録番号がマスタと不一致」と書いています。どちらも異常には気づいており、違いは保留にするかの判断です。5回中1回の差なので、モデルの優劣とまでは言えません。
結果2:Fable 5.1より速く、安くなった
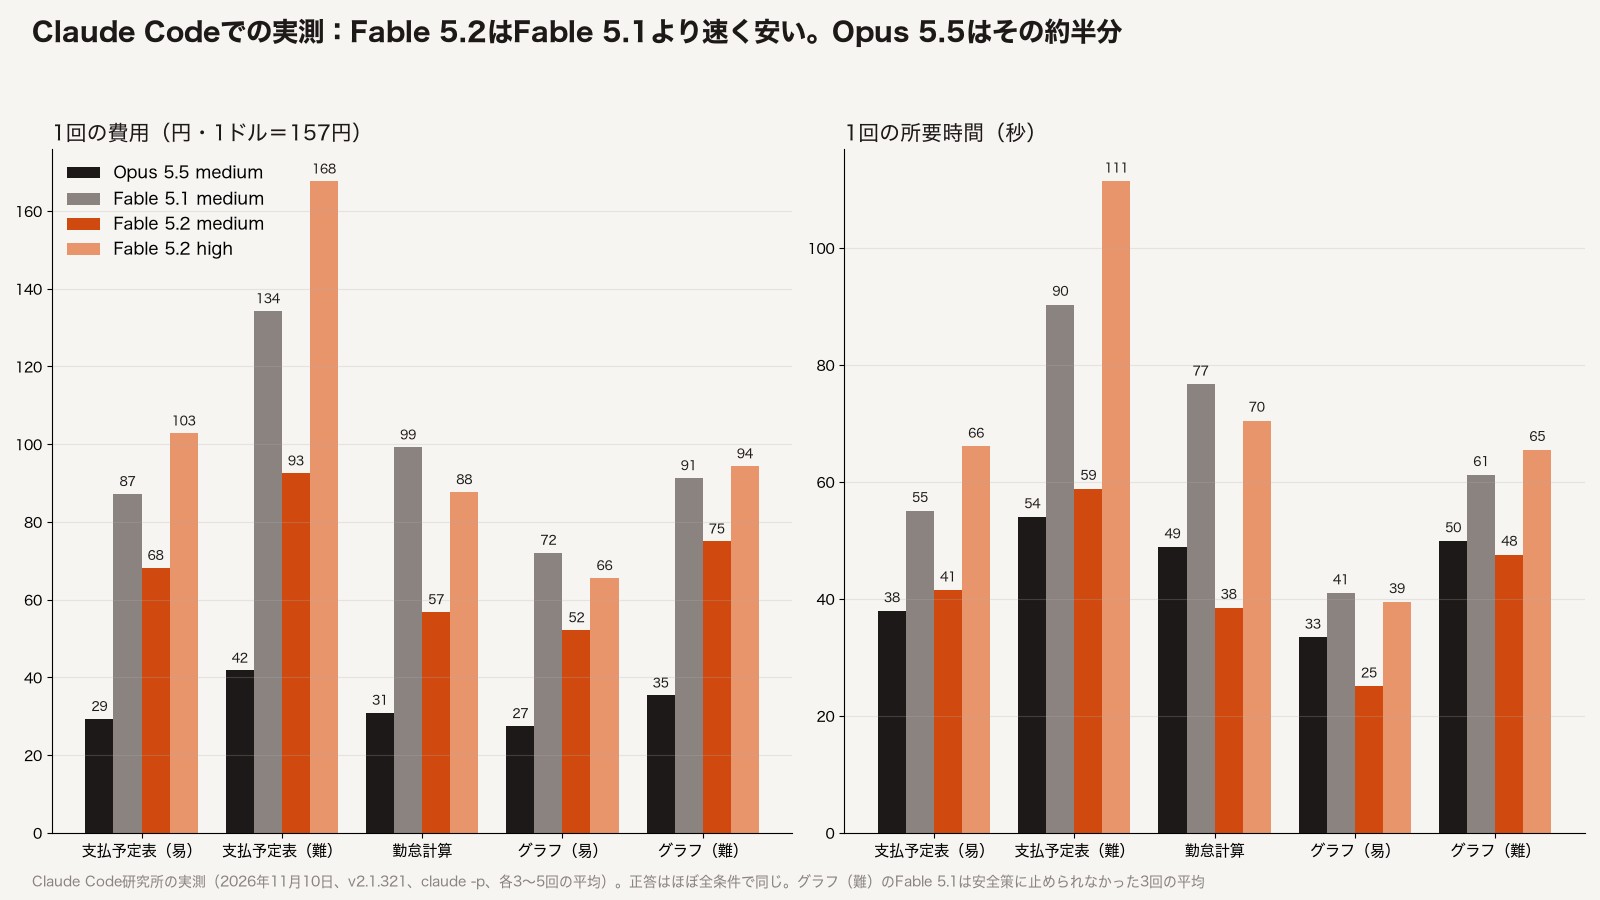
はっきり差が出たのは、時間と費用です。同じ課題でFable 5.2(medium)をFable 5.1(medium)と比べると、1回の費用は18〜43%安く、完了までの時間も21〜51%短くなりました。出力トークンを処理時間で割った速さは、Fable 5.1の毎秒80トークンに対し、Fable 5.2は毎秒107トークンでした。公式の「最大30%速い」とおおむね合います。
| 課題(1回あたりの平均) | Opus 5.5(medium) | Fable 5.1(medium) | Fable 5.2(medium) | Fable 5.2(high) |
|---|---|---|---|---|
| 支払予定表(易) | 29円・38秒 | 87円・55秒 | 68円・41秒 | 103円・66秒 |
| 支払予定表(難) | 42円・54秒 | 134円・90秒 | 93円・59秒 | 168円・111秒 |
| 勤怠計算 | 31円・49秒 | 99円・77秒 | 57円・38秒 | 88円・70秒 |
| グラフ読み取り(易) | 27円・33秒 | 72円・41秒 | 52円・25秒 | 66円・39秒 |
| グラフ読み取り(難) | 35円・50秒 | 91円・61秒(※) | 75円・48秒 | 94円・65秒 |
| Markdown変換器 | 975円・約44分 | 2,780円・約43分 | 639円・約10分 | 2,591円・約46分 |
| 出力の速さ(毎秒トークン) | 約100 | 約80 | 約107 | 約109 |
※費用は claude -p が返すAPI料金換算額(total_cost_usd)を1ドル=157円で換算。定額プランでは利用枠の消費として効きます。速さは出力トークン数を処理時間(duration_api_ms)で割った値で、道具の実行待ちを含む目安です。Fable 5.1のグラフ(難)は、安全策に止められなかった3回(フォルダ名を変えた再実行)の平均です。
出力トークンの量も、課題によってはFable 5.2のほうが少なくなりました。勤怠計算では平均5,867から3,611へ約38%減っています。公式の「mediumでは難しい仕事をFable 5.1より少ないトークンでこなせる」という説明とも合います。
結果3:ヒートマップの読み取りが大きく改善した
差がいちばん大きかったのは、色だけで値を表すヒートマップの読み取りです。96マスの平均誤差は、Fable 5.1が16.0〜17.5%(3回)だったのに対し、Fable 5.2は0.9〜2.0%(10回)で、約11分の1になりました。Fable 5.1は、96マスのうち誤差5%以内が36〜37マスにとどまりました。公式のChartography(グラフの読み取り)が44.8%から73.4%に伸びたことと合う結果です。Opus 5.5の誤差は1.6〜2.3%で、Fable 5.2がやや上回りました。
結果4:Fable 5.1はフォルダ名だけで安全策に止められた
検証中、Fable 5.1は作業フォルダの名前に「c2」が入っているだけで、最初の返答の前に安全策に止められました。グラフ読み取り(難)の課題を「c2-…」という名前のフォルダで動かしたときです。「C2」は、サイバー攻撃で使う指令サーバー(Command and Control)の略語でもあります。分類器はこれに反応したとみられます。止められると、Claude Codeは次のメッセージを出し、そのセッションの残りを別のモデル(Opus 4.8)に切り替えます。
「Fable 5.1の安全策がこのメッセージにフラグを立てました。意図的に広めにかけている安全策のおかげで、より多くの機能を早く届けられますが、正当なコーディングやサイバーセキュリティの作業に反応することもあります。Opus 4.8に切り替えました。」
"Fable 5.1's safeguards flagged this message. Our intentionally broad safeguards allow us to deliver more capabilities faster, but can sometimes flag legitimate coding and cybersecurity tasks. Switched to Opus 4.8."
Claude Code v2.1.321 のセッション記録(当研究所の実行、2026年11月10日)
確かめるため、同じ課題をフォルダ名だけ変えて動かすと、Fable 5.1は3回とも止められませんでした。逆に、易しいグラフ課題を「c2」入りのフォルダで動かすと、2回とも止められました。「c2」入りのフォルダでは7回中7回止められ、それ以外では一度も止められていません。一方、Fable 5.2は同じ「c2」入りのフォルダで10回動かして、一度も止められませんでした。Anthropicは不要な停止が約55%減ったとしており、今回の誤検知はFable 5.2では起きませんでした。
止められても作業は続くので、気づきにくい点に注意が必要です。セッションの記録(~/.claude/projects/ 以下のjsonl)やJSON出力の modelUsage にFable以外のモデルが出ていたら、この切り替えが起きています。結果が急に雑になったと感じたら、まずここを確かめてください。
結果5:一から作る長い課題では
Markdown変換器の課題では、4条件とも1,600〜1,900行の実装を書き、公式の652例すべてに通りました。差が出たのは、終えるまでの時間と費用です。Fable 5.2(medium)は約10分・639円で終わり、4条件で最も速く安く済みました(各1回)。
ほかの3条件は、自分で検証を重ねて40分以上かかりました。Fable 5.1(medium)とFable 5.2(high)は、仕様の例を記憶から書き起こしたり、別の変換器(pandocや、この端末に入っていたmarkdown-it-py)と出力を突き合わせたり、極端な入力での速度を調べたりしました。その結果、費用は2,500円を超えました。Opus 5.5もサブエージェントを立てて独立した確認を走らせ、約44分・975円でした。こうした検証の多くは、採点に使った652例には表れない速度や頑健さに向けたものです。そのため、かかった時間がすべて無駄だったとは言えません。なお、正解ファイルを読んだり、既存の実装をコピーしたりした形跡はありませんでした。
この課題は、モデルがCommonMarkの参照実装をよく知っているため、上位モデルには易しすぎました。公式ベンチマークで差が大きいのは、何時間も続く調査や、慣れないコードベースでの変更です。そうした仕事は今回の検証では測れていません。
この検証の限界
- 課題は当研究所が作った架空の業務で、1回あたり数十秒〜数十分で終わる規模です。公式ベンチマークのように何時間も続く仕事は測っていません
- 試行は各条件3〜5回(Markdown変換器は1回)です。Opus 5.5の見落とし(5回中1回)のような小さな差は、偶然の可能性があります
- 費用はAPI料金換算です。定額プランでは利用枠の消費として効き、Fableは週の上限の50%までという別枠もあります
- 発売翌日の測定で、混雑の影響を受けている可能性があります。条件は課題ごとに4本ずつ並列で実行しました
Fable 5.2とOpus 5.5の違いは?どの仕事で上げるべきか
Fable 5.2とOpus 5.5の違いは、長く難しい仕事での成績と費用です。Fable 5.2のほうが強い一方で、API単価は2倍で、Claude Codeの定額プランでも使える量に上限があります。Anthropic自身も、多くのコーディングや知的作業はOpus 5.5から始め、足りないときにFableへ上げるよう勧めています。当研究所の実測もこの方針を裏づけました。
「ほとんどのコーディングと知的作業は、日常の主力として最も強いClaude Opus 5.5から始めることを勧めます。」
"For most coding and knowledge tasks, we recommend that users start with Claude Opus 5.5, our strongest daily driver."
Anthropic — Introducing Claude Fable 5.2 and Claude Mythos 5.2
Addy Osmani氏(Anthropic)のモデル選びの解説は、Fable 5.2の出番として、大きなリファクタリングや移行、設計の計画、多数のサブエージェントの指揮、コーディング・金融・科学の最も難しい仕事、Opus 5.5をhighにしても足りないとき、長時間の放置実行を挙げています。また、上位モデルに上げる前に、まずeffortを上げてみるよう勧めています。これらを当研究所の実測と合わせると、次のように使い分けるのが目安です。
| 仕事の種類 | まず使うモデル | 理由 |
|---|---|---|
| 手順が書ける定型業務(集計・突合・書類作成・計算ルールの実装) | Opus 5.5(medium) | 実測で正確さは同じ、費用は約半分 |
| グラフ・図表・スキャン画像の読み取り | Opus 5.5、細かい値はFable 5.2 | ヒートマップの誤差はFable 5.2が約3割小さかった |
| 規程にない不正や異常に気づいてほしいチェック | Opus 5.5でも可(保留の基準を明記) | どのモデルも異常には気づいた。Opusは5回中1回、気づいたうえで支払にした |
| 大規模な改修・移行、何時間も任せる作業、深い調査 | Fable 5.2(high以上) | 公式ベンチマークで差が最も大きい領域 |
| Fable 5.1を使っていた作業 | Fable 5.2へ移行 | 速く安く、ヒートマップの読み取りも大きく改善 |
effortの使い分けはClaude Codeのeffortはいつ上げる?で、軽い仕事を安いモデルに回す方法はClaude Haiku 5.5の解説で詳しく扱っています。Opus 5.5にFable 5.2を相談役(advisor)として付けたときの正答と費用はClaude Code advisorの実測で比べています。
Claude CodeでFable 5.2を使う方法と料金・リセット
Claude CodeでFable 5.2を使うには、v2.1.321以降に更新し、/model fable で切り替えます。料金はAPIで入力8ドル・出力40ドル(100万トークンあたり)です。定額プランでは、Max・Ultra・Teamのプレミアム席で週の上限の50%まで使えます。Proは使用量クレジット払いですが、2026年11月16日まではFableが週の上限の50%まで含まれます。
# 版を確認(2.1.321以降が必要)
claude --version

# 起動時にFable 5.2を指定(fable は最新のFableを指す別名)
claude --model fable

# 会話の途中で切り替える
/model fable

# 版を固定したい・前の版に戻したい場合
/model claude-fable-5-2
/model claude-fable-5-1

# effortを変える(Claude Codeでの既定は medium)
/effort high| プラン | Fable 5.2の扱い(2026年11月10日時点) |
|---|---|
| Free | 使えない |
| Pro | 使用量クレジット(API料金)で使う。発売記念として11月9日〜16日(太平洋時間23:59)は週の上限の50%まで含まれ、リセット1回つき |
| Max・Ultra | 週の上限の50%まで含まれる。契約期間に応じてリセット1〜3回 |
| Team | プレミアム席は週の上限の50%まで。標準席はProと同じ発売記念の扱い |
| Enterprise | 利用可(割合の記載なし) |
| API | 入力8ドル・出力40ドル・キャッシュ読み込み0.20ドル・キャッシュ書き込み10ドル(100万トークンあたり) |
「リセット」は週の枠全体を戻すものではない
発売記念のリセットは、その週にFableで使った分を週の上限から差し引き、Fableの枠を回復します。5時間の枠がある場合は、モデルを問わず満タンに戻ります。上限そのものは増えず、週の枠全体が戻るわけでもありません。Max・Ultra・Teamのプレミアム席などには、初回の支払いからの契約期間に応じて、6か月未満は1回、6〜12か月は2回、12か月を超えると3回配られます。期限は2027年3月8日です。設定のUsageから使い、一度使うと取り消せません。Hacker Newsでは「週の枠が丸ごと戻ると思って使ってしまった」という声も出ていたので、使う前に仕組みを確認しておきましょう。
使うときの注意点
- fast mode:出力が最大2.5倍速くなる代わりに、単価は入力16ドル・出力80ドルの2倍です。Claude Codeの定額プランでは枠に含まれず、使用量クレジットからのみ払います(fast modeのドキュメント)
- 途中でモデルを替えると割高になりやすい:プロンプトのキャッシュはモデルごとに別です。長い会話の途中で切り替えるなら、先に /compact で要約してから替えると、読み直しの費用を抑えられます(Addy Osmani氏の解説)
- Fable 5.1を保存していた人:ProとMaxでは、保存済みの選択がすでにfable(=Fable 5.2)へ移っています。前の版を使い続けたい場合は /model claude-fable-5-1 で戻します
- 安全策の切り替え:Fable 5.2でも、サイバー攻撃や生物学の危険な分野に触れる依頼は止められることがあります。そのときは、サイバー系ならOpus 4.8、生物系ならOpus 5に自動で切り替わります
まとめ
この記事のまとめ
- Claude Fable 5.2(2026年11月9日公開)は、公式ベンチマークでFable 5.1からRemote Labor Indexが17.9%→41.3%、FrontierCode 2.0が32.4%→49.1%と伸び、ほぼ全項目でOpus 5.5を上回った
- Claude Codeで同じ課題を解かせると、Fable 5.1より出力は約34%速く、1回の費用は18〜43%安くなった
- ヒートマップの読み取り誤差はFable 5.1の16〜18%からFable 5.2では約1.5%に。Fable 5.1が作業フォルダ名の「c2」で安全策に止められた条件でも、Fable 5.2は10回とも止められなかった
- 1時間以内に終わる業務課題では、既定のOpus 5.5も同じ正確さで、費用はFable 5.2の約半分だった。普段はOpus 5.5、長く難しい仕事にFable 5.2が目安
- Claude Codeでは v2.1.321以降で /model fable。既定effortはmedium。Max・Ultraは週の上限の50%まで、Proは11月16日まで発売記念で50%まで使える
記事で紹介した設定を、自社の業務に合わせて組み上げる。
CLAUDE.mdによるプロジェクト規約の設定から、業務に合わせたオリジナルskillsの作成まで、一社ごとにヒアリングした業務を題材に対面で進めます。受講者限定のオリジナルskillsとプロンプトテンプレート集もお渡しします。
- 一社ごとに業務をヒアリングして設計
- 実際の業務データでハンズオン
- スパルタ以上は全額返金保証
- 受講法人数100社超
オンライン30分・無料。フォームは入力1分で、2営業日以内にご連絡します。
よくある質問
Fable 5.2とOpus 5.5の違いは何ですか?どちらを使うべきですか?
Fable 5.2は最上位、Opus 5.5は日常向けの主力です。公式の表ではFable 5.2がFrontierCode 2.0で49.1%対45.5%、Remote Labor Indexで41.3%対21.3%と上回りますが、API単価は2倍(入力8ドル・出力40ドル対4ドル・20ドル)です。Anthropicは多くの作業をOpus 5.5から始め、足りないときにFableへ上げるよう勧めています。当研究所の実測でも、1時間以内に終わる業務課題では正確さに差がなく、Opus 5.5の費用が約半分でした。
Claude CodeでFable 5.2を使うにはどうすればいいですか?
Claude Code v2.1.321以降で /model fable と入力するか、起動時に claude --model fable を付けます。fableはFable 5.2を指す別名で、版を固定したい場合は claude-fable-5-2 と書きます。Claude Codeでの既定effortはmediumで、/effort high などで変えられます。保存していたFable 5.1の選択は、ProとMaxではすぐ、TeamとEnterpriseでは組織が許可したときにfableへ移ります。
Fable 5.2の料金はいくらですか?Proプランでも使えますか?
APIでは入力100万トークンあたり8ドル、出力40ドル、キャッシュ読み込み0.20ドルで、Fable 5.1(10ドル・50ドル)より2割安くなりました。定額プランでは、MaxとUltraとTeamのプレミアム席が週の上限の50%まで使えます。Proは使用量クレジット(API料金)払いですが、2026年11月9日から16日(太平洋時間23:59)まではFableが週の上限の50%まで含まれます。いずれも2026年11月10日時点の料金ページとヘルプ記事にもとづきます。
Fable 5.2の「リセット」とは何ですか?
発売記念で配られる、Fableの利用枠を回復する権利です。使うと、その週にFableで使った分が週の上限から差し引かれ、5時間の枠がある場合はモデルを問わず満タンに戻ります。上限そのものは増えず、週の枠全体が戻るわけでもありません。Max・Ultra・Teamのプレミアム席などには契約期間に応じて1〜3回(6か月未満は1回)配られ、期限は2027年3月8日です。Proと標準席は1回で、期限は11月16日です。設定のUsageから使い、取り消しはできません。
Fable 5.2はeffortをhighにしたほうが良いですか?
まずは既定のmediumで十分なことが多いです。当研究所の業務課題では、highにすると出力トークンが約1.4〜2倍に増えましたが、正答は変わらず、差が出たのはヒートマップの読み取り誤差(平均1.46%→1.14%)くらいでした。公式の比較ではhighのFable 5.2がFrontierCodeでOpus 5.5の最高値と並び、費用は約半分とされています。長く難しいコーディングや調査ではhighやxhighを試し、普段の作業はmediumのまま使うのが目安です。
参考資料・出典
- 公式ブログ・記事Introducing Claude Fable 5.2 and Claude Mythos 5.2
ベンチマーク表、費用対性能の図、料金、速度、安全策の誤ブロック55%減、提供範囲
- 公式ブログ・記事Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku
モデルの使い分け、既定effort(Claude Codeはmedium)、モデル切り替え時のキャッシュの注意
- 公式ブログ・記事Safely scaling multi-agent teams with Claude Fable 5.2
1,000体のエージェントでフェルマーの最終定理の形式化を28.7時間で完了した実験
- 公式ドキュメントClaude Fable 5.2 launch offers
リセットの中身・配布回数・期限、Proの発売記念期間
- 公式ドキュメントModel configuration
fable別名、Fable 5.2の既定effortがmedium、v2.1.321以降が必要
- 公式ドキュメントChangelog(2.1.321)
Fable 5.2の追加と、保存済みのFable 5.1の選択がfableへ移る変更
- 公式ドキュメントSpeed up responses with fast mode
Fable 5.2のfast modeは16ドル・80ドル、使用量クレジットのみ
- 公式ドキュメントModels overview
100万トークンの文脈、最大出力12.8万トークン、知識の基準時点2026年6月、APIの既定effort high
- 公式ドキュメントPlans & Pricing
プラン別のFableの扱い(Max・Ultraは週の上限の50%まで、Proは使用量クレジット)
- スレッドClaude Fable 5.2 and Mythos 5.2
866ポイントの反響、リセットを週の枠全体の回復と誤解した報告
- 公式ドキュメントCommonMark Spec 0.31.2(spec.json)
Markdown変換器の課題の採点に使った公式の652例
Claude Codeを実務で活用したい方へ
一社ごとにカスタマイズする対面のClaude Code研修は「スパルタClaude Code塾」。経営者・士業・エンジニア・マーケター・営業職まで、業務をヒアリングしてカリキュラムを設計します。まずは30分の無料相談で、自動化プランと費用対効果をご確認ください。